億級用戶時代 分布式數(shù)據(jù)存儲的架構演進與實踐

在數(shù)字化轉(zhuǎn)型的浪潮中,如何為億級用戶提供穩(wěn)定、高效且可擴展的數(shù)據(jù)存儲服務,已成為眾多互聯(lián)網(wǎng)企業(yè)面臨的核心挑戰(zhàn)。王知無在其《從Java到大數(shù)據(jù)之路》系列博客中,深入探討了這一領域的解決方案,為我們揭示了從傳統(tǒng)架構向分布式存儲演進的技術脈絡與實踐智慧。
一、 億級用戶帶來的數(shù)據(jù)存儲挑戰(zhàn)
當用戶規(guī)模突破億級,傳統(tǒng)的單體數(shù)據(jù)庫或簡單的主從架構往往不堪重負。數(shù)據(jù)量呈指數(shù)級增長(海量性),高并發(fā)讀寫請求(高并發(fā)性),對服務可用性與數(shù)據(jù)一致性要求極高(高可用與強一致),并且業(yè)務需求快速變化要求架構具備彈性伸縮能力(可擴展性)。這些挑戰(zhàn)迫使技術架構必須進行根本性的革新。
二、 分布式數(shù)據(jù)存儲的核心設計思想
應對上述挑戰(zhàn),現(xiàn)代分布式存儲系統(tǒng)普遍遵循幾個核心設計原則:
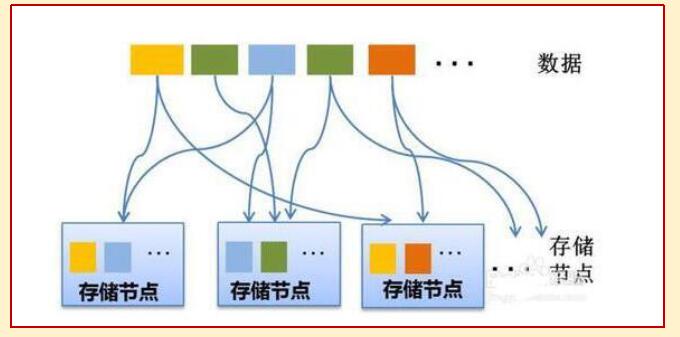
- 分而治之(Sharding/Partitioning):將龐大的數(shù)據(jù)集水平拆分到多個數(shù)據(jù)庫實例或節(jié)點上,分散存儲與計算壓力。這要求設計良好的分片鍵(Shard Key)以保證數(shù)據(jù)分布均勻與查詢效率。
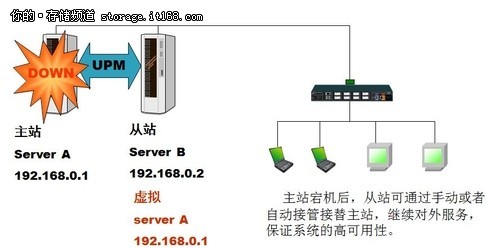
- 冗余復制(Replication):同一份數(shù)據(jù)在多個節(jié)點上保存副本,是保證高可用和容錯的基礎。根據(jù)一致性要求的不同,有主從復制、多主復制、無中心復制(如Paxos、Raft共識算法)等模式。
- 彈性伸縮(Elastic Scalability):系統(tǒng)應能根據(jù)負載動態(tài)增加或減少節(jié)點,且對應用透明。這涉及數(shù)據(jù)的自動重平衡(Rebalancing)技術。
- 最終一致性與BASE理論:在追求高性能和高可用的場景下,可以適當放寬對強一致性的要求,采用最終一致性模型。BASE(Basically Available, Soft state, Eventually consistent)理論是這類系統(tǒng)的基石。
三、 主流分布式存儲解決方案選型
根據(jù)數(shù)據(jù)結(jié)構與訪問模式的不同,解決方案大致分為幾類:
- 分布式關系型數(shù)據(jù)庫:如Google Spanner(及其開源實現(xiàn)如TiDB、CockroachDB),在提供SQL接口和ACID事務的實現(xiàn)了全球級的分布與水平擴展。
- 分布式鍵值(Key-Value)存儲:如Redis Cluster、etcd,適用于緩存、會話存儲和配置管理等高性能場景。
- 分布式文檔/列族存儲:如MongoDB、Cassandra、HBase,擅長處理半結(jié)構化數(shù)據(jù),具備靈活的模式和良好的水平擴展能力。
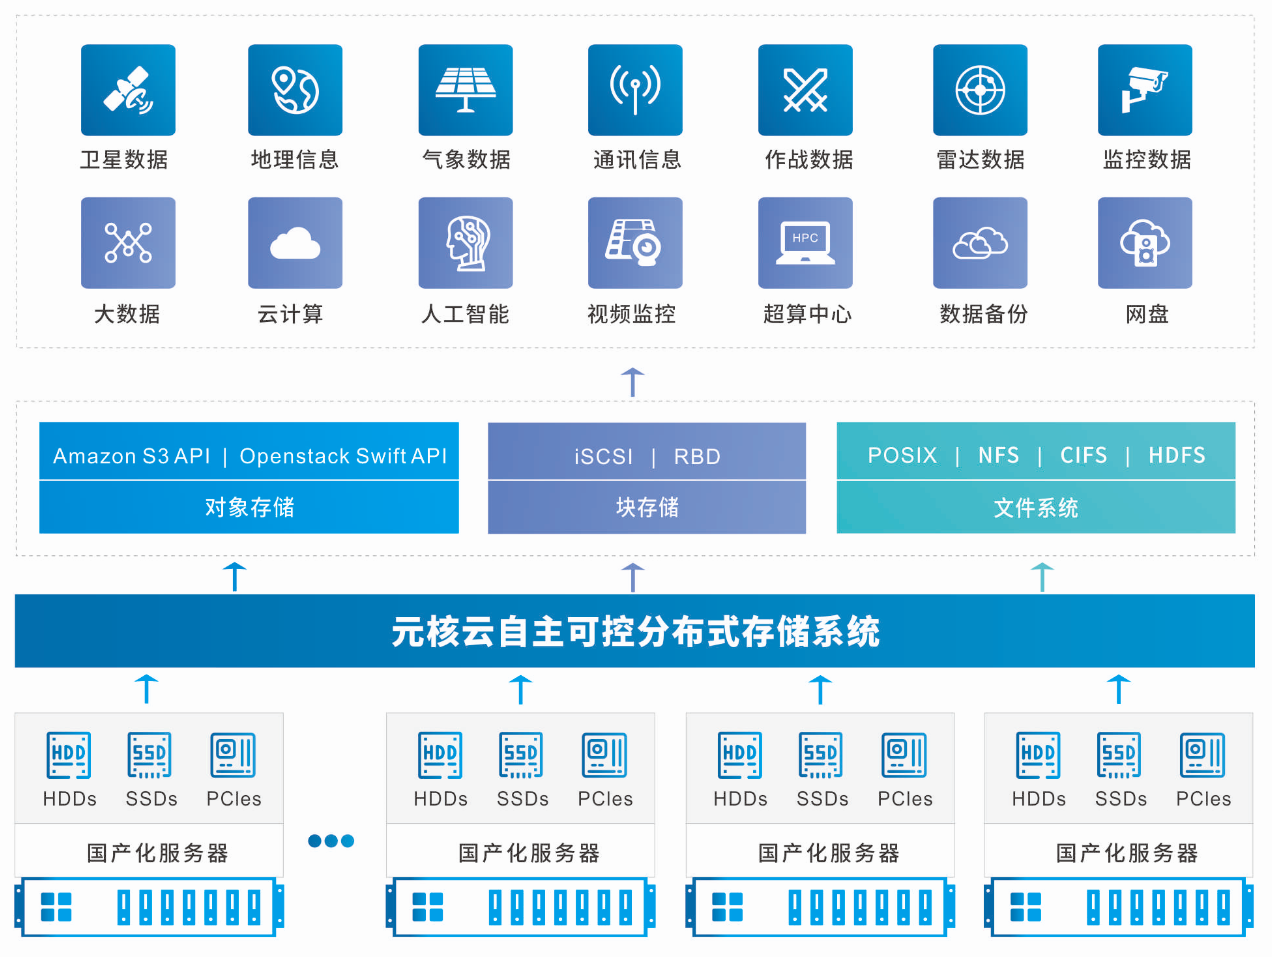
- 分布式對象存儲:如AWS S3、MinIO,專為存儲圖片、視頻、日志等海量非結(jié)構化數(shù)據(jù)設計。
- 分布式文件系統(tǒng):如HDFS、Ceph,為大數(shù)據(jù)分析(如Hadoop/Spark生態(tài))提供底層存儲支撐。
選型時需綜合考量數(shù)據(jù)模型、一致性要求、讀寫模式、延遲敏感度以及運維成本。
四、 從Java應用到大數(shù)據(jù)體系的架構融合
正如王知無在博客中梳理的路徑,現(xiàn)代Java后端開發(fā)者必須理解大數(shù)據(jù)存儲生態(tài)。典型的融合架構是“分層存儲”:
- 在線事務層(OLTP):使用分布式關系數(shù)據(jù)庫或文檔數(shù)據(jù)庫處理核心業(yè)務交易,保證實時性和一致性。
- 在線分析層(OLAP):通過數(shù)據(jù)同步工具(如Canal、Debezium)將事務層數(shù)據(jù)實時或準實時導入到像ClickHouse、Doris或大數(shù)據(jù)平臺(Hive/Spark on HDFS)中,供復雜分析與報表使用。
- 數(shù)據(jù)湖與流處理層:使用Kafka作為實時數(shù)據(jù)流總線,將日志、事件數(shù)據(jù)匯入數(shù)據(jù)湖(如Iceberg、Hudi on HDFS/S3),并通過Flink/Spark Streaming進行實時處理,形成數(shù)據(jù)閉環(huán)。
五、 數(shù)據(jù)處理與存儲支持服務的關鍵實踐
構建穩(wěn)定的支持服務,離不開以下實踐:
- 監(jiān)控與告警:對集群健康度、性能指標(QPS、延遲、吞吐)、容量進行全方位監(jiān)控。
- 自動化運維:利用Ansible、Kubernetes Operators等實現(xiàn)集群的自動化部署、擴縮容與升級。
- 備份與容災:制定跨機房、跨地域的數(shù)據(jù)備份與災難恢復策略,定期進行容災演練。
- 成本優(yōu)化:根據(jù)數(shù)據(jù)冷熱特性實施分層存儲(如S3標準存儲與冰川存儲),清理無效數(shù)據(jù),優(yōu)化資源使用。
- 安全與治理:實施細粒度的訪問控制、數(shù)據(jù)加密(傳輸中與靜態(tài))和審計日志,滿足合規(guī)要求。
服務于億級用戶的分布式數(shù)據(jù)存儲系統(tǒng),沒有一成不變的“銀彈”。它是一條持續(xù)演進的道路,需要根據(jù)業(yè)務特性,在一致性、可用性、分區(qū)容錯性(CAP定理)之間做出權衡,并靈活組合各類技術組件。王知無的分享提示我們,從扎實的Java開發(fā)走向廣闊的大數(shù)據(jù)架構,核心在于掌握分布式系統(tǒng)的基本原理,并保持對新技術棧的開放與實踐精神。只有這樣,才能構建出真正支撐業(yè)務騰飛的數(shù)據(jù)基石。
如若轉(zhuǎn)載,請注明出處:http://www.zjluluxin.cn/product/22.html
更新時間:2026-10-15 22:20:51